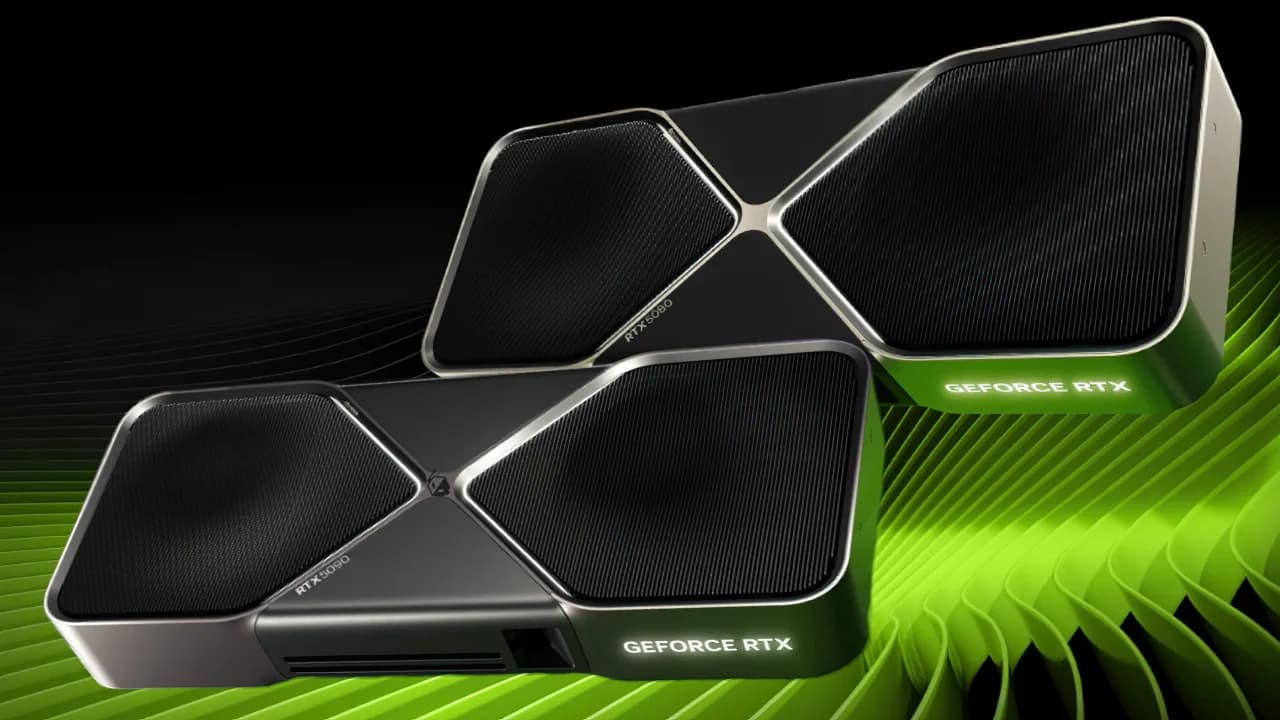
NVIDIA’nın GeForce RTX 30 ve RTX 40 serisi ekran kartlarında belirli yapay zekâ hesaplamalarının hızını sınırlayan mekanizma aşıldı. Açık kaynaklı yazılım projeleriyle gerçekleştirilen testlerde RTX 4090’ın Tensor hesaplama performansı iki katına kadar yükseldi.
RTX 3090 Ti, RTX 4070 Ti SUPER ve RTX 4060 Ti gibi modellerde de dikkat çekici sonuçlar elde edilirken, yöntem ekran kartlarının BIOS’unu veya NVIDIA sürücülerini değiştirmeden uygulanabiliyor.
NVIDIA ekran kartlarının Tensor çekirdeklerindeki performans sınırlamasını aşan yeni yazılım yöntemleri, GPU Unlock ve GPU Unlock Ada projeleriyle kullanıma sunuldu. Ampere mimarili RTX 30 serisi için geliştirilen ilk yöntem, Ada Lovelace mimarisini kullanan RTX 40 serisine de uyarlandı. Böylece ekran kartlarının donanımsal özellikleri değiştirilmeden belirli matematiksel işlemlerde daha yüksek hesaplama hızlarına ulaşılması sağlandı.
RTX 4090 üzerinde gerçekleştirilen testlerde FP16 verilerle yapılan ve FP32 hassasiyetinde biriktirme kullanan Tensor işlemlerinin performansı 165,6 TFLOPS seviyesinden 331,6 TFLOPS’a yükseldi. BF16 işlemlerinde ise 165,5 TFLOPS olan değer 330,6 TFLOPS’a çıktı. Her iki hesaplama türünde de yaklaşık iki katlık artış kaydedildi.
Ekim ayının 24’ünde gerçekleştirilen bağımsız RTX 4090 testleri de performans artışını doğruladı. Aynı ekran kartı, NVIDIA 615.78.08 sürücüsü ve 450W güç sınırıyla yapılan karşılaştırmada FP16 hesaplama hızı 160,4 TFLOPS’tan 320,4 TFLOPS’a, BF16 hızı ise 159,7 TFLOPS’tan 320,2 TFLOPS’a yükseldi. Testlerde sayısal sonuçların doğruluğu da kontrol edildi.
Ancak teorik işlem yürütme kapasitesindeki iki katlık artış, gerçek uygulamalara aynı oranda yansımıyor. RTX 4090 üzerinde cuBLAS kullanılarak gerçekleştirilen matris çarpımı testlerinde FP16 performansı işlenen matrislerin boyutuna bağlı olarak yüzde 12 ile yüzde 34 arasında arttı. BF16 işlemlerinde bazı testlerde yüzde 16 ile yüzde 20 arasında kazanç sağlanırken, 4096 boyutlu matris testinde anlamlı bir performans farkı oluşmadı.
RTX 4070 Ti SUPER üzerinde de benzer sonuçlar elde edildi. 240W güç sınırında gerçekleştirilen ölçümlerde FP16 Tensor işlem hızı 95 TFLOPS’tan 189,9 TFLOPS’a, BF16 hızı ise 189,7 TFLOPS’a yükseldi. TF32 işlemlerinde 47,49 TFLOPS olan performans 94,51 TFLOPS’a çıkarak yaklaşık yüzde 99 arttı.
RTX 4070 Ti SUPER’ın FP8 performansında ise kullanılan hesaplama yöntemine bağlı olarak farklı sonuçlar ortaya çıktı. İlk CUTLASS testinde 59,326 TFLOPS olan değer 59,495 TFLOPS’a çıkarak yalnızca yüzde 0,3 arttı.
Ancak CUTLASS 4.8.1’in hızlı biriktirme yöntemini kullanan başka bir testte performans 158,54 TFLOPS’tan 309,08 TFLOPS’a yükseldi. Yaklaşık 1,95 katlık artış elde edilen bu ikinci ölçümde, her iki durumda da aynı hesaplama çekirdeği ve 240W güç sınırı kullanıldı.
RTX 40 serisindeki çalışmalar RTX 4060 Ti 16 GB modeline de genişletildi. AD106 GPU’sunu kullanan ekran kartında 24 Ekim tarihinde gerçekleştirilen ilk denemede Tensor hesaplama hızını belirleyen donanım ayarları değiştirildi ve NVIDIA 595.99.02 sürücüsü sorunsuz şekilde başlatıldı. 165W güç sınırındaki testlerde FP16 için 91 TFLOPS, TF32 için 46,9 TFLOPS ve INT4 için 374,9 TOPS değerleri ölçüldü. Ancak aynı ekran kartında yöntem uygulanmadan önce eşdeğer bir performans testi gerçekleştirilmediği için kesin hızlanma oranı henüz belirlenmedi.
RTX 4080 SUPER için de FP16 hesaplama hızının 110,6 TFLOPS’tan 202,7 TFLOPS’a yükseldiğini öne süren test sonuçları paylaşıldı. Bununla birlikte bu model için diğer ekran kartlarında olduğu gibi ayrıntılı donanım doğrulaması ve karşılaştırmalı test kayıtları henüz mevcut değil. RTX 40 serisinin bütün modellerinde aynı yöntemin sorunsuz çalıştığı da doğrulanmadı.
Windows tarafında ise RTX 4070 Ti üzerinde ayrı bir UEFI uygulamasıyla test gerçekleştirildi. MSI RTX 4070 Ti ve Z490 anakart kullanılan sistemde, FP16 matris çarpımı performansı 84,08 TFLOPS’tan 151,43 TFLOPS’a yükselerek yüzde 80,1 arttı. BF16 performansı da 84,03 TFLOPS’tan 148,25 TFLOPS’a çıkarak yüzde 76,4 yükseldi. Ancak bu yöntem yalnızca belirli bir donanım yapılandırmasında denendi ve bütün Windows sistemlerine kurulabilen genel bir uygulama olarak yayınlanmadı.
RTX 30 serisinde geliştirilen GPU Unlock projesi ise GA102, GA103, GA104 ve GA106 grafik işlemcilerinin belirli Tensor komutlarını daha yüksek hızda çalıştırmasını sağlıyor. RTX 3090 Ti ile yapılan testlerde FP16 matris çarpımı performansı 87,46 TFLOPS’tan 118,39 TFLOPS’a yükseldi. BF16 işlemlerinde 87,50 TFLOPS’tan 157,41 TFLOPS’a, TF32 işlemlerinde ise 42,58 TFLOPS’tan 82,61 TFLOPS’a ulaşıldı.
RTX 3090, RTX 3080, RTX 3070 ve RTX 3060 modellerinden de başarılı test sonuçları paylaşıldı. BF16 matris çarpımı testlerinde RTX 3090 için yüzde 25 ile yüzde 67, RTX 3080 10 GB için yüzde 70 ile yüzde 73, RTX 3070 için yüzde 73 ile yüzde 81 arasında performans artışları kaydedildi. Sonuçlar kullanılan ekran kartının güç sınırına, test koşullarına ve çalıştırılan iş yüküne bağlı olarak değişiyor.
Büyük dil modelleri üzerinde gerçekleştirilen testlerde de performans kazanımları görüldü. Özellikle modelin giriş verilerini işlediği prefill aşamasında yüzde 14 ile yüzde 36 arasında hızlanmalar ölçüldü. Buna karşılık bellek bant genişliğiyle sınırlanan token üretimi aşamasında ve INT8 hesaplamalarında benzer artışlar gerçekleşmedi.
Yeni yöntemin çalışma prensibi, ekran kartının Tensor işlemleri için kullandığı hız seçimi ayarlarına müdahale edilmesine dayanıyor. Linux üzerinde çalışan çekirdek modülü, NVIDIA’nın standart ekran kartı sürücüsü başlatılmadan önce GPU’nun ilgili ayarlarını değiştiriyor. Ardından PCIe Function Level Reset işlemi gerçekleştiriliyor ve NVIDIA sürücüsü normal şekilde yükleniyor.
RTX 4090 üzerinde kullanılan yöntem, TOTORONG tarafından geliştirilen AD102 firmware çalışmasının GPU Unlock altyapısına uyarlanmasıyla oluşturuldu. Yazılım, gerekli firmware bileşenlerini kullanıcının bilgisayarında hazırlıyor ve açılış sırasında devreye giriyor. Linux uygulamasında ekran kartının vBIOS yazılımının yeniden yüklenmesi veya NVIDIA sürücüsünün değiştirilmesi gerekmiyor.
Bununla birlikte işlem, basit bir sürücü güncellemesinden farklı. Linux sistemlerde çekirdek modülünün kurulması, açılış yapılandırmasının düzenlenmesi ve yöntemin NVIDIA sürücüsünden önce çalıştırılması gerekiyor. İlk uygulamada bilgisayarın tamamen kapatılarak yeniden açılması da gerekli olabiliyor. Secure Boot yapılandırması ve çekirdek modülü imzalama gereksinimleri kullanılan sisteme göre değişiyor.
Yöntem henüz bütün ekran kartları ve sistem yapılandırmaları üzerinde uzun süreli kararlılık testlerinden geçmedi. Ayrıca Tensor çekirdeklerindeki belirli işlem sınırlamalarının kaldırılması, oyunlardaki kare hızının veya ekran kartının bütün hesaplama birimlerinin performansının iki katına çıkmasını sağlamıyor. Yapılan ölçümlerde standart FP32 işlemleriyle INT8 hesaplamalarının büyük ölçüde önceki seviyelerinde kaldığı görüldü.
GPU Unlock projelerinin kaynak kodları GitHub üzerinden yayınlandı. GPU Unlock Ada’nın 1.1.1 sürümü RTX 4090, deneysel RTX 4070 Ti SUPER ve RTX 4060 Ti 16 GB desteğini içerirken, RTX 30 serisi için geliştirilen orijinal sürümde de kullanıcı testleri devam ediyor. RTX 4090 D desteği ayrıca deneysel seçenekler arasında bulunuyor.
1996 yılında Üsküdar’da doğan Mert Can Aka, sinema, bilim, teknoloji ve tarih alanlarına duyduğu ilgiyle şekillenen kariyerinde teknoloji editörlüğüne odaklandı. Öğrenmeyi ve bilgiyi aktarmayı merkeze alan Aka, farklı kurumlarda çeşitli görevler üstlendi. Bu süreçte MediaMarkt’ın MediaTrend Teknolojik Yaşam dergisini son sayısına kadar yöneterek dergicilik tarafında da deneyim kazandı. Bilgisayar Mühendisliği, Bilgisayar Programcılığı, Web Tasarım ve Kodlama ile birlikte Adalet ve İktisat alanlarında akademik geçmişe sahip olan Aka, bugün Technopat’ta Yazı İşleri Müdürü olarak görev yapıyor. Otomotivden yapay zekaya, donanımdan ev teknolojilerine uzanan geniş bir yelpazede ürettiği on bini aşkın içerik yüz milyonlarca okura ulaştı.
Kaynak: Technopat